新闻资讯
聚焦全球 IPv4 代理资源、跨境业务实践、网络安全与产品动态,持续分享可落地的行业观察。
Qwen3.8-Max冲进第一梯队:大模型竞争,正在从“会回答”走向“能干活”
但现在模型竞争已经进入新阶段:谁能理解需求,谁能拆任务,谁能调用工具,谁能自己试错,谁能最终交付一个能用的结果,才是真正的分水岭。据原文提到,在第三方榜单Arena的最新结果中,Qwen3.8-Max进入全球大模型第一梯队,文本能力表现接近Claude系列。
#人工智能#阿里千问
大模型市场又被阿里Qwen搅动了一次。
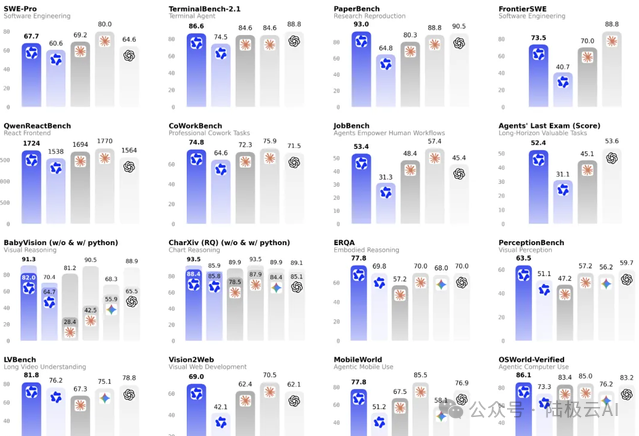
近日,阿里巴巴发布新一代基座大模型Qwen3.8-Max。按照原文信息,这一版本总参数量达到2.4万亿,在编程、专业工作、长程任务、多模态理解和智能体执行等场景里都有明显升级。
如果只用一句话概括这次更新,我更愿意说:Qwen3.8-Max想证明的不是“我也能聊”,而是“我能把复杂任务做完”。
这也是它最值得关注的地方。
过去大家评价一个模型,常常看问答、推理、写作、代码补全这些单点能力。但现在模型竞争已经进入新阶段:谁能理解需求,谁能拆任务,谁能调用工具,谁能自己试错,谁能最终交付一个能用的结果,才是真正的分水岭。
据原文提到,在第三方榜单Arena的最新结果中,Qwen3.8-Max进入全球大模型第一梯队,文本能力表现接近Claude系列。
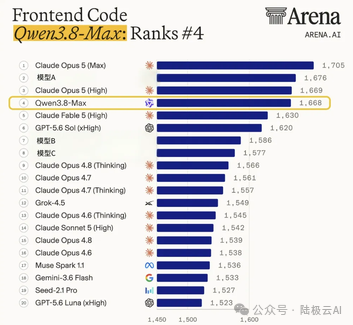
在编程相关榜单里,它的表现也非常突出,甚至被拿来和Claude Opus、Fable等高端模型对比。
性能之外,价格同样是这次发布的核心看点。
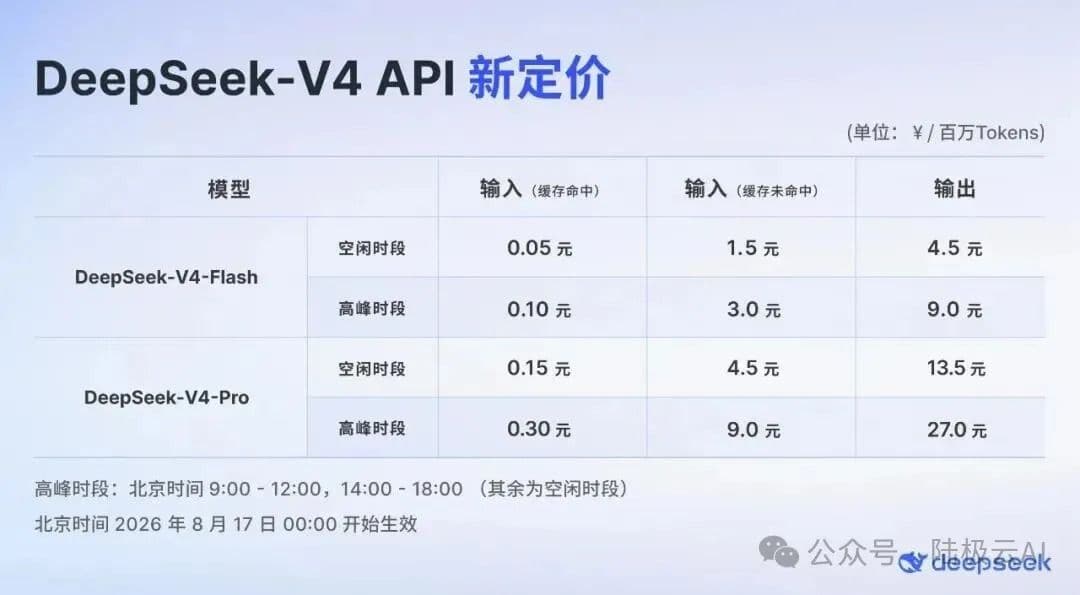
原文给出的价格信息是:国内每百万tokens输入12元、输出36元,隐式缓存命中价格为1.5元。按照文章中的对比口径,其输入和输出价格分别只有Opus 5的一部分。这意味着,Qwen3.8-Max试图把“强模型”从少数高预算用户手里,推向更大规模的真实使用场景。
这点很关键。
因为企业和个人真正使用模型时,最怕的不是模型不够聪明,而是模型聪明但用不起。尤其是长文档分析、代码开发、视频理解、Agent自动执行这类任务,一旦上下文很长、调用次数很多,token成本会迅速变成一道门槛。
原文还提到,抢先体验预览版的用户已经给出了不少反馈:有人用它复刻小游戏,也有人只靠一条提示词搭出了可交互的开发者作品集。
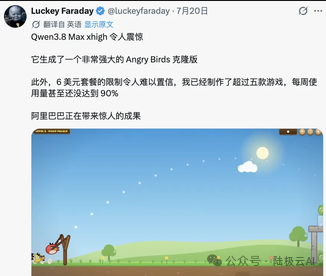
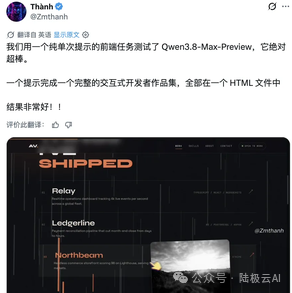
围绕模型表现,社交平台上也出现了一批讨论:有人期待尽快上手,有人把它和海外头部模型继续对比,也有人认为其表现超出预期。
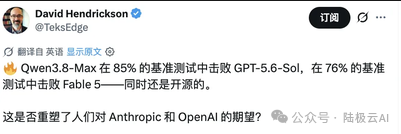
所以,Qwen3.8-Max这次真正想打的,可能不是单一榜单,而是“能力、场景、成本”这三个维度的同时平衡。
从原文实测来看,作者主要做了三类测试。
【图片位置08:Qwen3.8-Max能力/评测总览图】
第一类是编程交付。
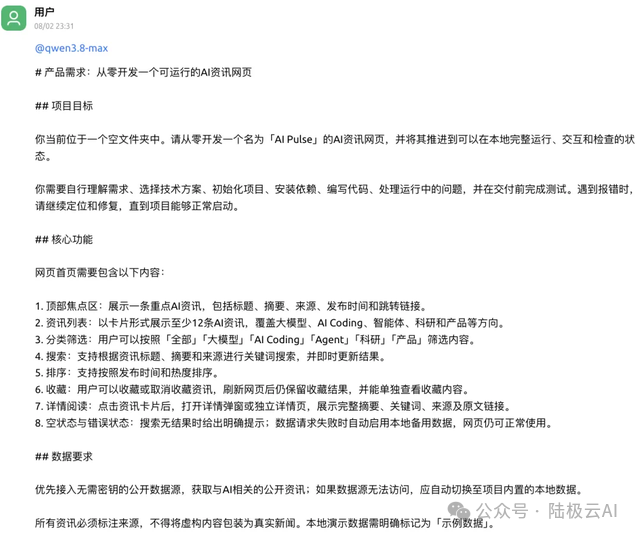
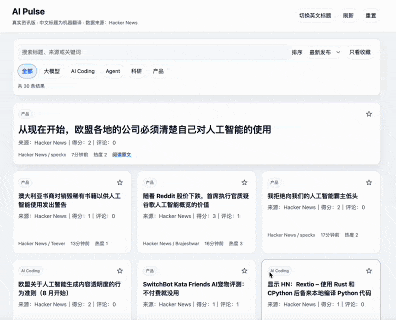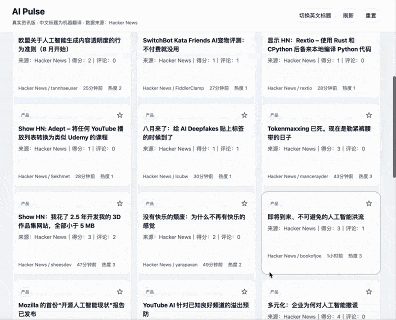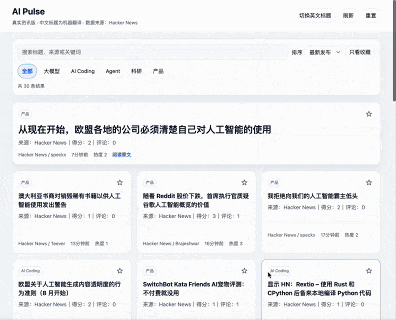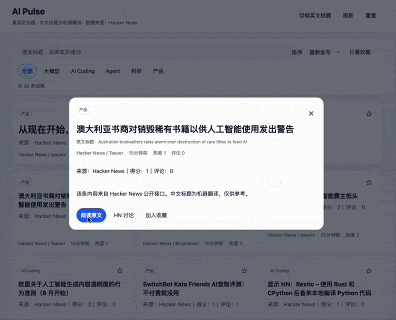
作者给Qwen3.8-Max写了一份比较完整的产品需求,让它从零开发一个可运行的AI资讯网页。需求里不仅包括核心功能,还包含数据结构、页面体验、技术约束、验收标准和交付要求。
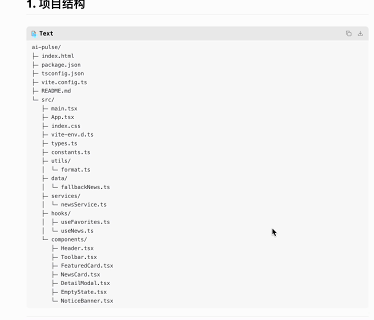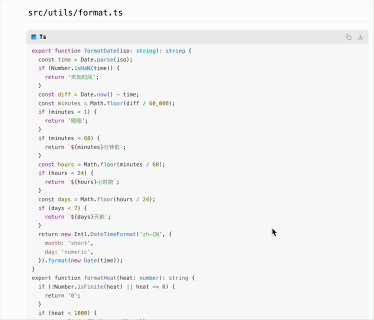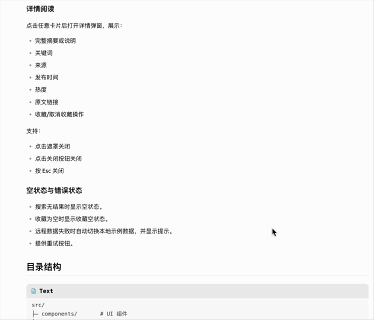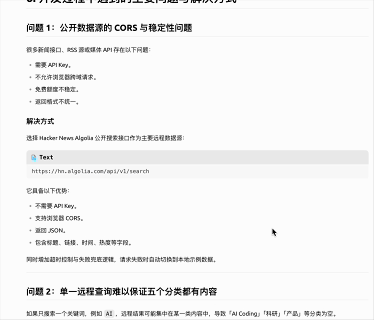
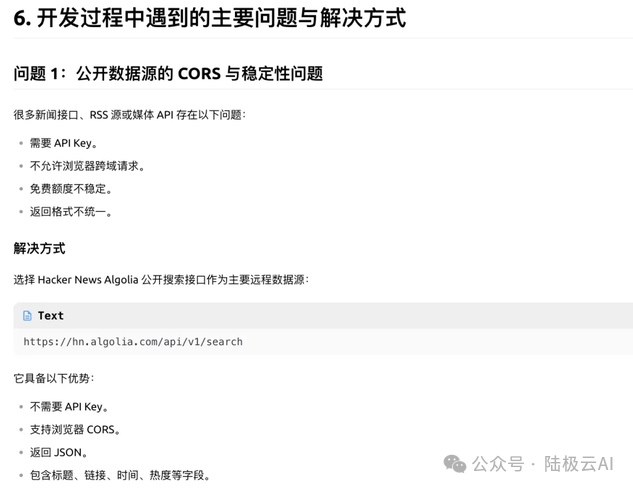
结果是,模型不仅完成了页面开发,还给出了需求拆解、技术选型、项目结构、功能实现说明,并整理了开发过程中遇到的问题和解决记录。
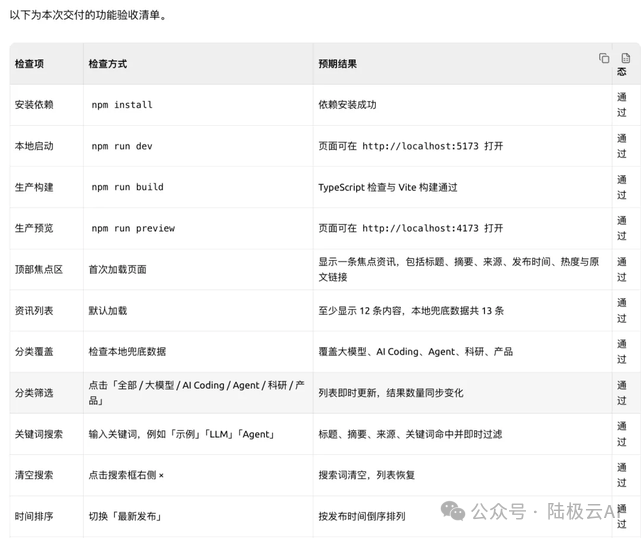
更重要的是,它在交付前做了功能验收,包括依赖安装、本地启动、生产构建、预览验证、数据数量、分类覆盖、搜索恢复等细节。
【图片位置11:问题与解决记录/功能验收清单】
这已经不是“生成一段代码”的范畴,而更接近一个工程流程:先理解任务,再搭建项目,再运行验证,再修问题,最后交付。
第二类测试是长文本和复杂文档分析。
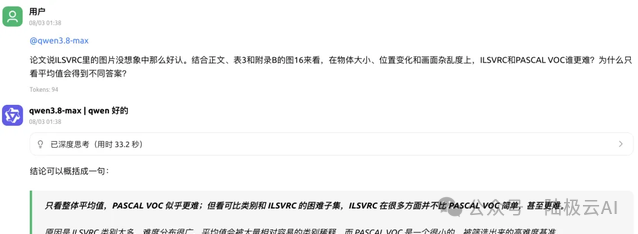
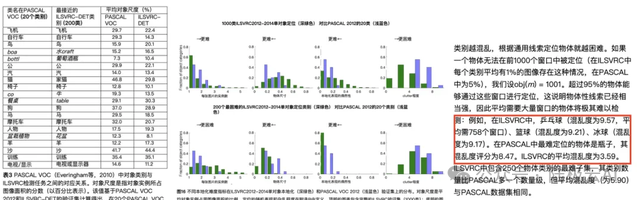
作者把一篇几十页的论文交给模型,让它结合正文、表格和附录图表,回答ILSVRC与PASCAL VOC两套视觉数据集哪一套更难,以及为什么从平均值和困难类别两个角度会得到不同结论。
这类问题难点不在于关键词检索,而在于跨章节、跨表格、跨图像信息的综合判断。模型需要把散落在不同位置的证据串起来,再给出清晰结论。
按照原文描述,Qwen3.8-Max给出的答案是:如果只看整体平均值,PASCAL VOC似乎更难;但如果看可比类别和ILSVRC的困难子集,ILSVRC在多个指标上并不比PASCAL VOC简单,甚至可能更难。
作者随后对照原论文表格、图16和附录信息,认为这个回答和原文证据是对应得上的。
这种回答体现出的不是单纯摘要能力,而是“带证据的交叉分析”能力。
第三类测试是多模态内容理解。
作者又让模型处理一期接近70分钟的视频播客,任务是生成完整主题时间轴,并按“话题观点”定位原始片段。这个任务要求模型不仅能理解视频内容,还要梳理人物、事件和观点之间的关系,并把结论映射回对应时间段。
原文称,Qwen3.8-Max在几分钟内完成了按核心观点划分的内容整理,每个话题都采用先总结、再展开的结构,同时标注了对应时间戳。对于需要快速消化长视频、长访谈、课程或会议记录的人来说,这类能力非常实用。
把这三类测试放在一起看,Qwen3.8-Max的重点其实很清楚:它想做一个能跨场景完成任务的模型,而不是只在某个单项能力上刷分。
编程场景里,它强调端到端交付。
文档场景里,它强调跨材料分析。
视频场景里,它强调长内容理解和精准定位。
这些能力组合起来,正是下一阶段AI Agent最需要的底层能力。用户不只是要一个回答,更需要一个可检查、可复用、可落地的结果。
当然,所有实测结论都还需要更多用户和更复杂场景来验证。榜单成绩、官方案例、个人测试,都只能说明一部分问题。模型在真实业务里是否稳定,长任务里是否会偏航,复杂工具链里是否足够可靠,仍然需要持续观察。
但至少从这次发布释放出的信号看,Qwen3.8-Max已经把竞争焦点往前推了一步:高性能模型不只要强,还要便宜;不只要能回答,还要能交付;不只要适合展示,更要适合长期使用。
这对整个大模型市场都是一个压力信号。
过去,很多顶级模型给人的印象是“好用但贵”。而更便宜的模型,又常常要在能力、稳定性或场景覆盖上做取舍。Qwen3.8-Max试图打破这种二选一,把头部能力和更低使用成本放在同一张牌桌上。
如果后续大规模使用体验能够跟上,那么它的意义可能不只是“阿里又发了一个新模型”,而是国产大模型在全球头部竞争中开始进入一个更务实的位置:不只追参数和榜单,也开始追交付效率、使用成本和真实生产力。
这或许才是Qwen3.8-Max最值得看的地方。
大模型竞争到今天,真正的胜负手已经越来越不像发布会上的一句“更强”,而是用户打开之后能不能少返工一点,少花钱一点,更快拿到一个真正能用的结果。
如果Qwen3.8-Max能稳定做到这一点,那它确实会让不少人重新评估“便宜”和“强大”之间的关系。
想用Qwen3.8-Max,又不想被复杂的接口配置和Token费用劝退?
一个账号即可调用Qwen、Claude、GPT、Gemini等主流模型,按量计费,用多少充多少,更适合AI编程、长文档分析、内容创作和Agent任务等高频场景。
Related